Tanpa index, mencari satu baris di tabel berisi sepuluh juta baris berarti membaca satu per satu dari awal. Dengan index yang tepat, database cukup menelusuri beberapa langkah. Itulah mengapa index adalah alat optimasi paling berpengaruh pada database relasional.
Analogi indeks buku
Buku tebal punya indeks di bagian belakang: daftar istilah terurut abjad beserta nomor halamannya. Kamu tidak membalik semua halaman untuk mencari "Normalisasi"; kamu membuka indeks, menemukannya cepat karena terurut, lalu langsung ke halamannya. Index database bekerja sama: struktur terpisah berisi nilai kolom yang terurut beserta penunjuk ke baris aslinya.
Struktur di balik layar: B-tree
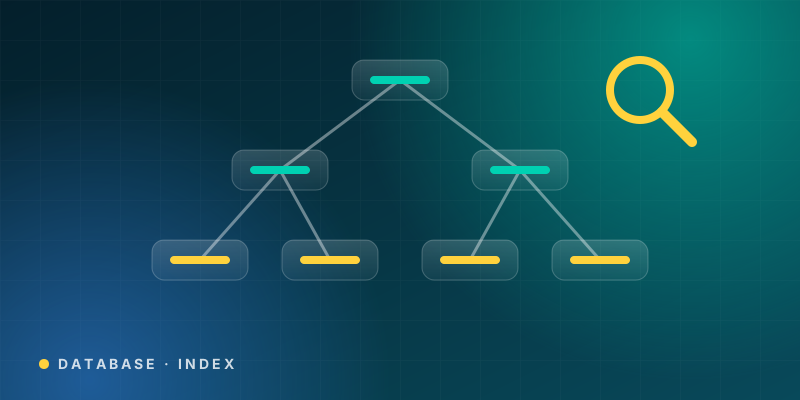
Mayoritas index di MySQL (InnoDB) berupa B+tree: pohon seimbang yang tetap dangkal meski datanya sangat besar. Tabel dengan jutaan baris biasanya hanya butuh sekitar 3-4 level pohon, sehingga mencari satu nilai cukup 3-4 pembacaan halaman, bukan jutaan.
B-tree mendukung:
- pencarian persis (
=), - rentang (
>,<,BETWEEN), - pengurutan (
ORDER BY), - awalan teks (
LIKE 'abc%').
Namun tidak mendukung LIKE '%abc' (wildcard di depan), karena urutan tidak membantu mencari bagian tengah teks.
Jenis index yang perlu kamu tahu
| Jenis | Fungsi |
|---|---|
| PRIMARY KEY | Identitas unik; di InnoDB menentukan urutan fisik data (clustered index) |
| UNIQUE | Mencegah duplikasi sekaligus mempercepat pencarian |
| INDEX biasa | Mempercepat pencarian/pengurutan pada kolom |
| Composite (gabungan) | Index pada beberapa kolom sekaligus |
| FULLTEXT | Pencarian teks kata demi kata |
| Spatial | Data geografis |
Di InnoDB, setiap index sekunder menyimpan nilai primary key sebagai penunjuk. Karena itu PK yang besar (misalnya UUID teks panjang) membuat semua index sekunder ikut membesar.
Membuat dan melihat index
CREATE INDEX idx_pelanggan ON pesanan (pelanggan_id);
CREATE UNIQUE INDEX uq_email ON pengguna (email);
SHOW INDEX FROM pesanan;
EXPLAIN SELECT * FROM pesanan WHERE pelanggan_id = 42;
Jika kolom key di hasil EXPLAIN menampilkan nama indexmu, index itu dipakai.
Composite index dan aturan leftmost prefix
Index gabungan (pelanggan_id, status, dibuat_pada) bekerja seperti buku telepon yang diurutkan berdasarkan nama belakang, lalu nama depan. Kamu bisa mencari berdasarkan nama belakang saja, atau nama belakang + depan, tetapi tidak efisien jika hanya tahu nama depan.
Untuk index (a, b, c):
| Query WHERE | Memakai index? |
|---|---|
a = 1 | Ya |
a = 1 AND b = 2 | Ya |
a = 1 AND b = 2 AND c = 3 | Ya (penuh) |
a = 1 AND c = 3 | Sebagian (hanya a) |
b = 2 | Tidak (tidak diawali kolom pertama) |
b = 2 AND c = 3 | Tidak |
Bagaimana menentukan urutan kolom?
- Kolom yang diuji dengan kesamaan (
=) di depan. - Kolom untuk rentang (
>,BETWEEN) atauORDER BYdi belakang, karena kolom setelah rentang tidak bisa dimanfaatkan untuk penyaringan. - Pertimbangkan kolom dengan selektivitas (kardinalitas) tinggi lebih dulu jika semuanya
=.
Contoh: query WHERE pelanggan_id = ? AND status = 'bayar' ORDER BY dibuat_pada DESC paling cocok dengan index (pelanggan_id, status, dibuat_pada): semua penyaringan dan pengurutan selesai lewat index tanpa filesort.
Covering index
Jika semua kolom yang diminta query ada di dalam index, database tidak perlu membuka tabel sama sekali. Di EXPLAIN muncul Using index.
-- index (pelanggan_id, total)
SELECT pelanggan_id, SUM(total) FROM pesanan GROUP BY pelanggan_id;
Sangat berguna untuk query laporan yang sering dipanggil.
Index tidak selalu menolong
Index bisa tidak dipakai bahkan ketika ada. Penyebab umum:
- Fungsi pada kolom:
WHERE DATE(dibuat_pada) = '2025-01-01'. - Konversi tipe implisit: kolom string dibandingkan dengan angka.
LIKE '%kata'dengan wildcard di depan.- Selektivitas rendah: kolom dengan sedikit nilai berbeda (misalnya
jenis_kelamin, boolean) jarang berguna sendirian. Jika 90% baris cocok, membaca seluruh tabel justru lebih murah dan optimizer akan memilihnya. - Tabel kecil: ratusan baris cukup dibaca langsung.
Biaya index
Index bukan gratis:
- INSERT/UPDATE/DELETE lebih lambat, karena setiap index harus ikut diperbarui.
- Memakai ruang disk dan memori (buffer pool).
- Terlalu banyak index membingungkan optimizer dan menyulitkan perawatan.
Aturan praktis: buat index berdasarkan query nyata yang sering jalan dan lambat, bukan untuk setiap kolom "jaga-jaga". Hapus index yang tak pernah dipakai (cek sys.schema_unused_indexes di MySQL 8) dan index duplikat (index (a) redundan jika sudah ada (a, b)).
Menambah index di tabel besar
CREATE INDEX di tabel puluhan juta baris bisa memakan waktu dan membebani server. InnoDB pada MySQL 8 mendukung online DDL (ALGORITHM=INPLACE, LOCK=NONE) untuk banyak operasi. Tetap uji di staging, jalankan di jam sepi, dan siapkan rencana pembatalan.
Di Laravel
$table->index('pelanggan_id');
$table->index(['pelanggan_id', 'status', 'dibuat_pada']);
$table->unique('email');
$table->fullText('isi');
Studi kasus singkat
Tabel log_aktivitas 8 juta baris, query dashboard WHERE user_id = 7 ORDER BY dibuat DESC LIMIT 20 memakan 2,4 detik (type: ALL, Using filesort). Setelah CREATE INDEX idx_user_waktu ON log_aktivitas (user_id, dibuat), EXPLAIN menunjukkan type: ref dengan ±20 baris diperiksa, dan waktu turun ke hitungan milidetik. Satu index, bukan server baru.
Kesimpulan
Index adalah struktur terurut yang menukar sedikit biaya penulisan dan ruang dengan kecepatan baca yang besar. Pahami B-tree, aturan leftmost prefix, dan covering index; buat index berdasarkan query nyata; lalu verifikasi dengan EXPLAIN. Lanjutkan ke Tips Optimasi Query Database MySQL untuk konteks yang lebih luas.
Komentar (0)
Masuk / Daftar